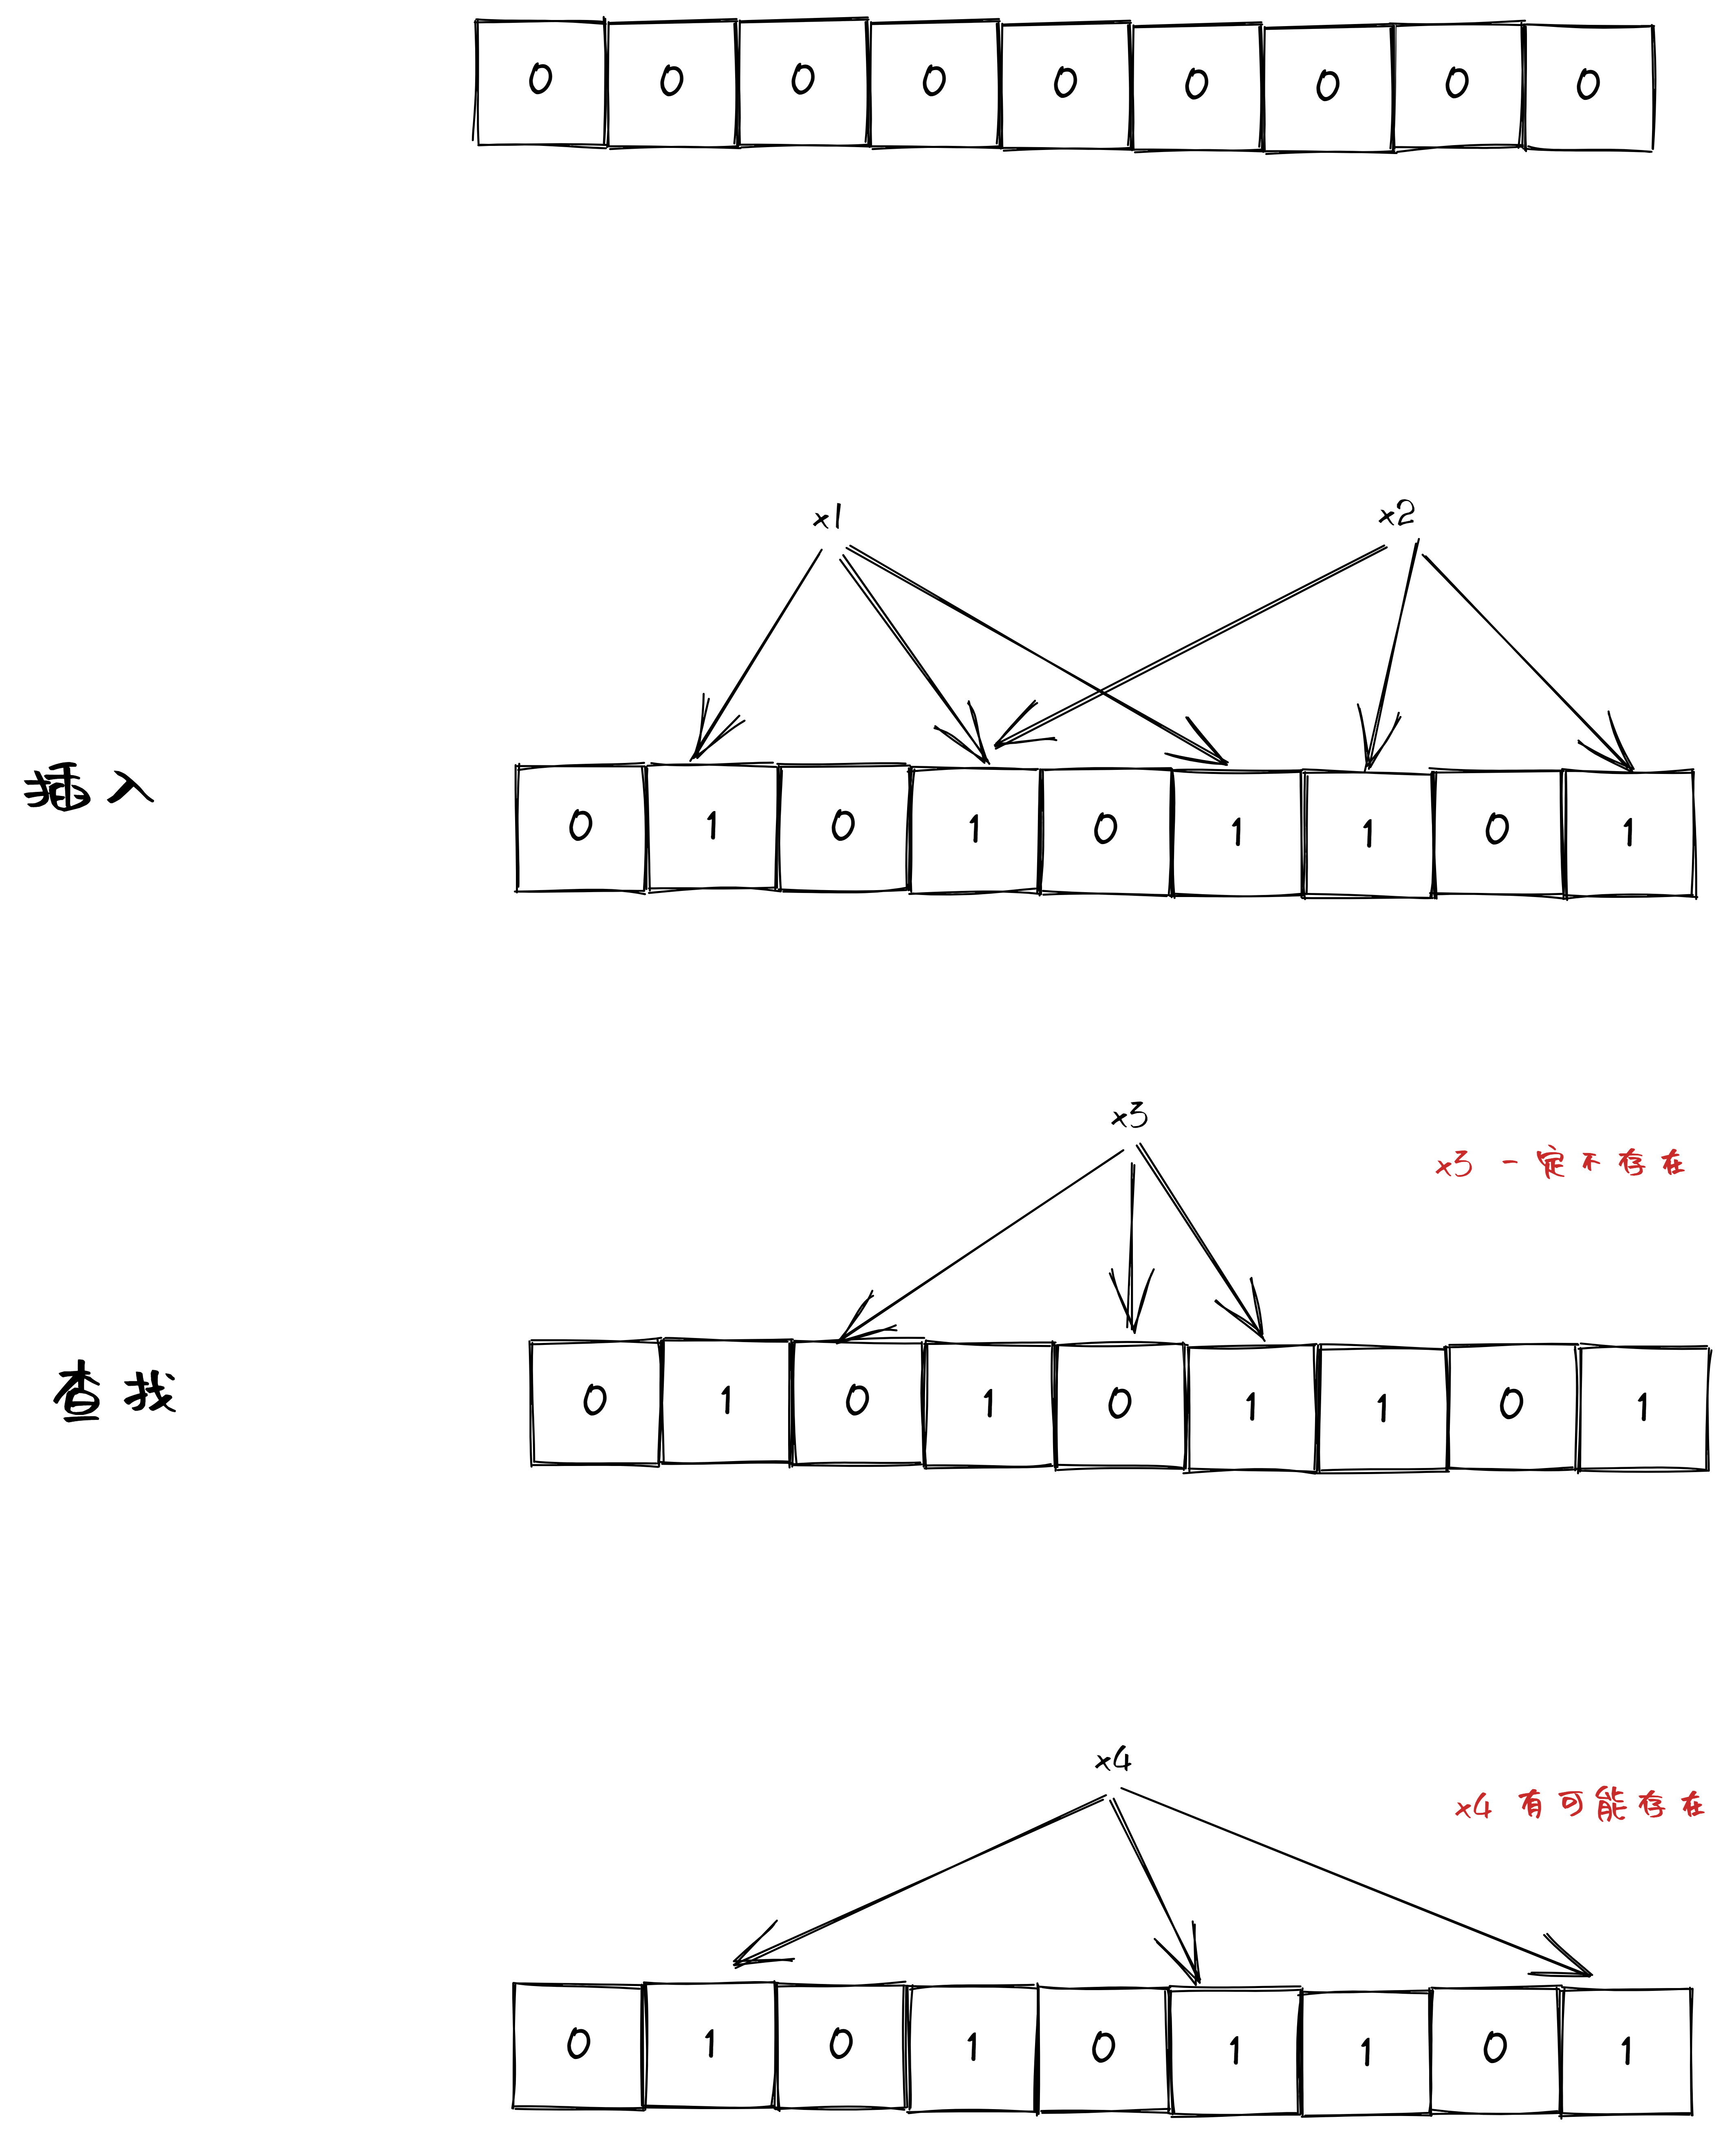
影响布隆过滤器精度的参数有
对于给定的 m 和 n,要想最小化错误率(假阳性),k 应该取
要求错误率不大于\(\varepsilon\),k 取最优的情况下,m 应该至少为
优点
O(k)缺点
LevelDB 中利用布隆过滤器判断指定的 key 值是否存在于 sstable 中
使用布隆过滤器可以有效的减少调用 DB::Get() 时的访存次数,从而减小读放大
LevelDB 中布隆过滤器的实现是 BloomFilterPolicy,它是接口类 FilterPolicy 的实现
FilterPolicy 类决定了查找过程中要不要读取某个 sstableFilterPolicy 的子类来应用不同的过滤策略LevelDB 实现时做了优化,它并不是使用 k 个哈希函数,而是应用 rsa2008 中提出的方法只生成一次哈希值,然后用 double-hashing 的方式生成一组哈希值
uint32_t h = BloomHash(keys[i]); const uint32_t delta = (h >> 17) | (h << 15); // Rotate right 17 bits for (size_t j = 0; j < k_; j++) { const uint32_t bitpos = h % bits; array[bitpos / 8] |= (1 << (bitpos % 8)); h += delta; }一般实现布隆过滤器时,都会选择非加密哈希算法
做查询的时候,缓存没有命中,就会到数据库中去找,特别地,如果查找一个不存在的 key,那么是一定无法命中缓存,必须去查数据库的,如果有人恶意地使用大量请求来查不存在的 key,就会导致数据库压力过大,甚至崩溃,这种现象称为缓存穿透
用布隆过滤器我们可以直接将这些针对不存在的 key 发起的请求过滤掉
本文来自博客园,作者:路过的摸鱼侠,转载请注明原文链接:https://www.cnblogs.com/ljx-null/p/16120507.html