写这篇博客的初衷是加深自己对网络请求发送和响应的理解,仅供学习使用,请勿用于非法用途!文明爬虫,从我做起。下面进入正题。
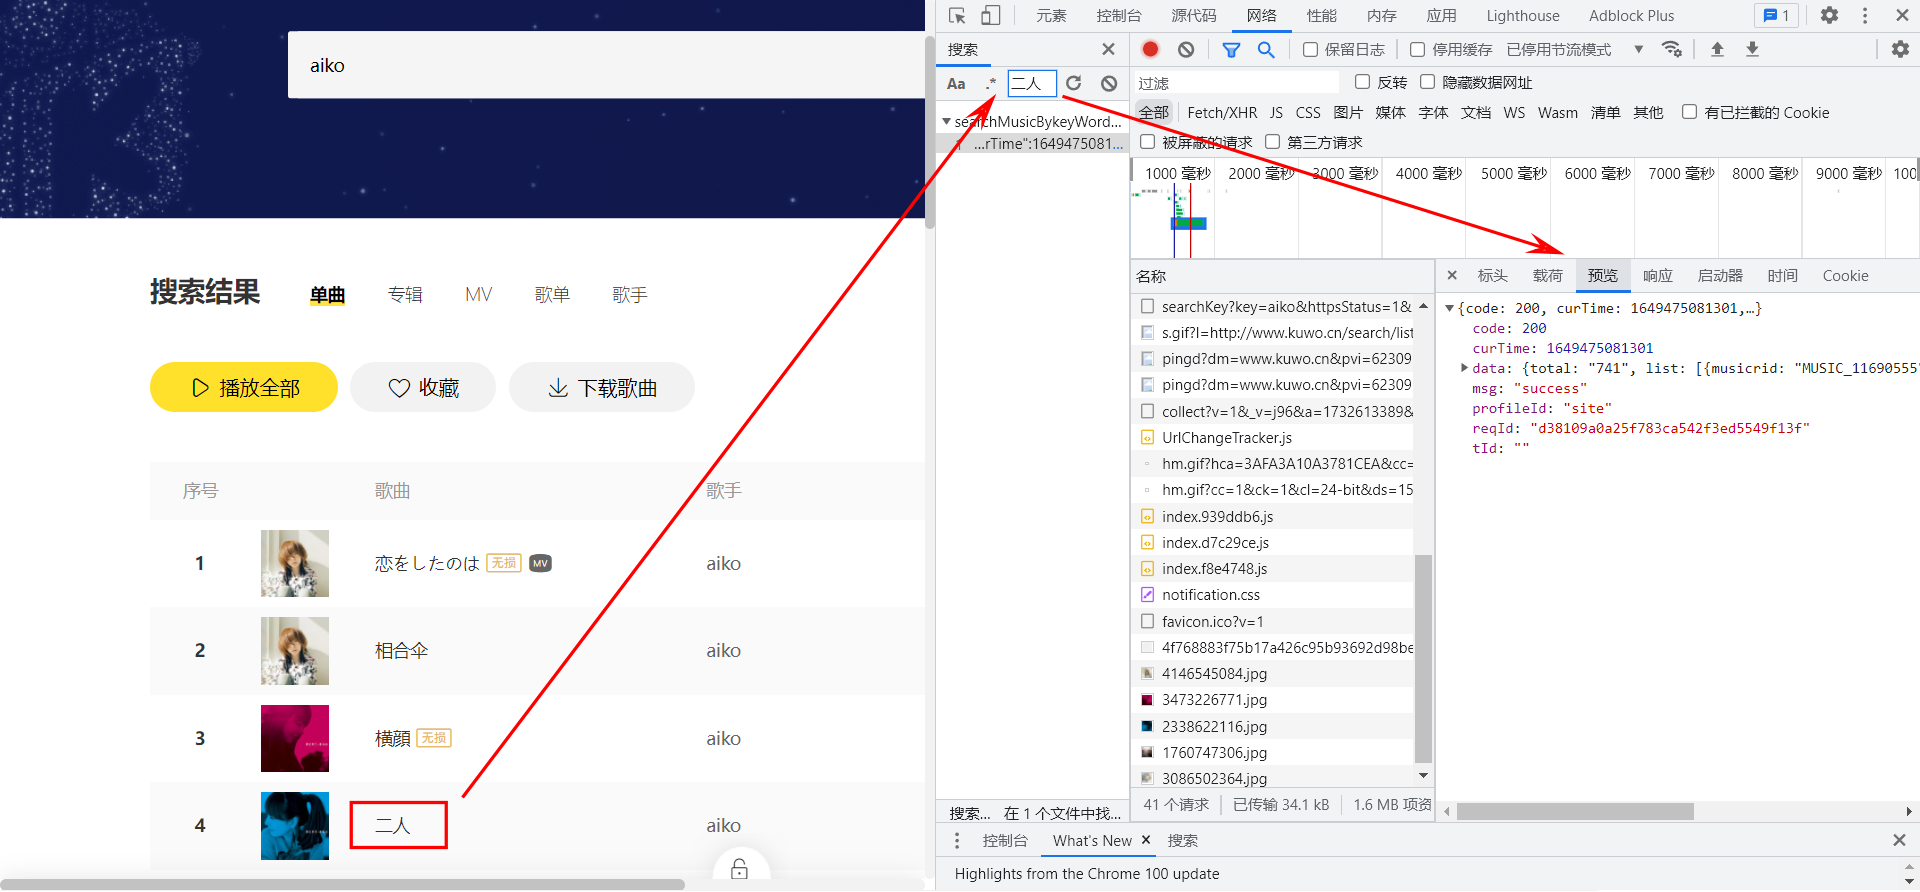
在酷我的搜索框中输入关键词 aiko,回车之后可以看到所有和 aiko 相关的歌曲。打开开发者模式,在网络面板下按下 ctrl + f,搜索 二人,可以找到响应结果中包含 二人 的请求,这个请求就是用来获取歌曲信息列表的。
请求的具体格式如下图所示,可以看到请求路径为 http://www.kuwo.cn/api/www/search/searchMusicBykeyWord,请求参数包括:
key: 搜索关键词,此处为 aikopn: 页码,page number 的缩写,此处为 1rn: 每页条目数,应该是 row number 的缩写,默认为 30httpsStatus:https 的状态?感觉没啥大用,看了源代码里面是直接写死 t.url = t.url + "?reqId=".concat(n, "&httpsStatus=1")reqId:请求标识,刷新页面之后值会发生改变,不知道有啥用,待会儿模拟请求的时候试着不带上他会怎么样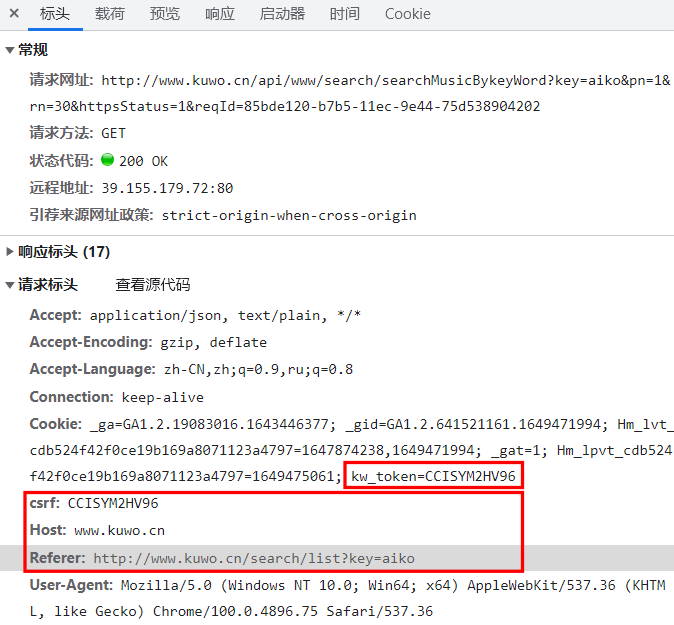
打开 Apifox(当然 postman 也行),新建一个接口,把请求路径和参数设置为下图所示的样子,为了让响应结果简短点,这里把每页的条目数设置为 1 而非默认的 30:
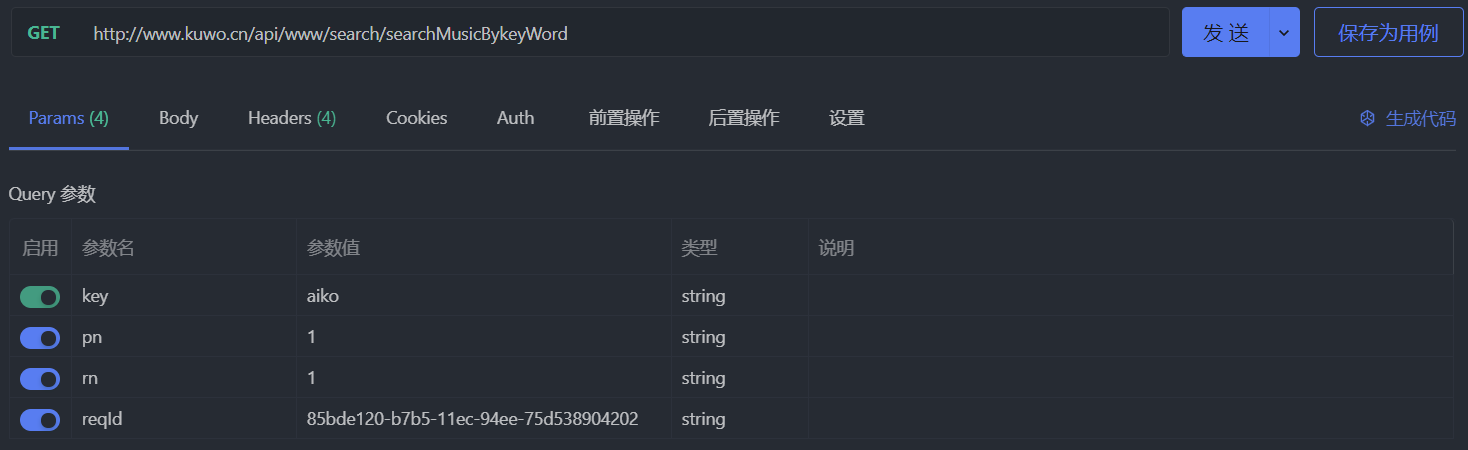
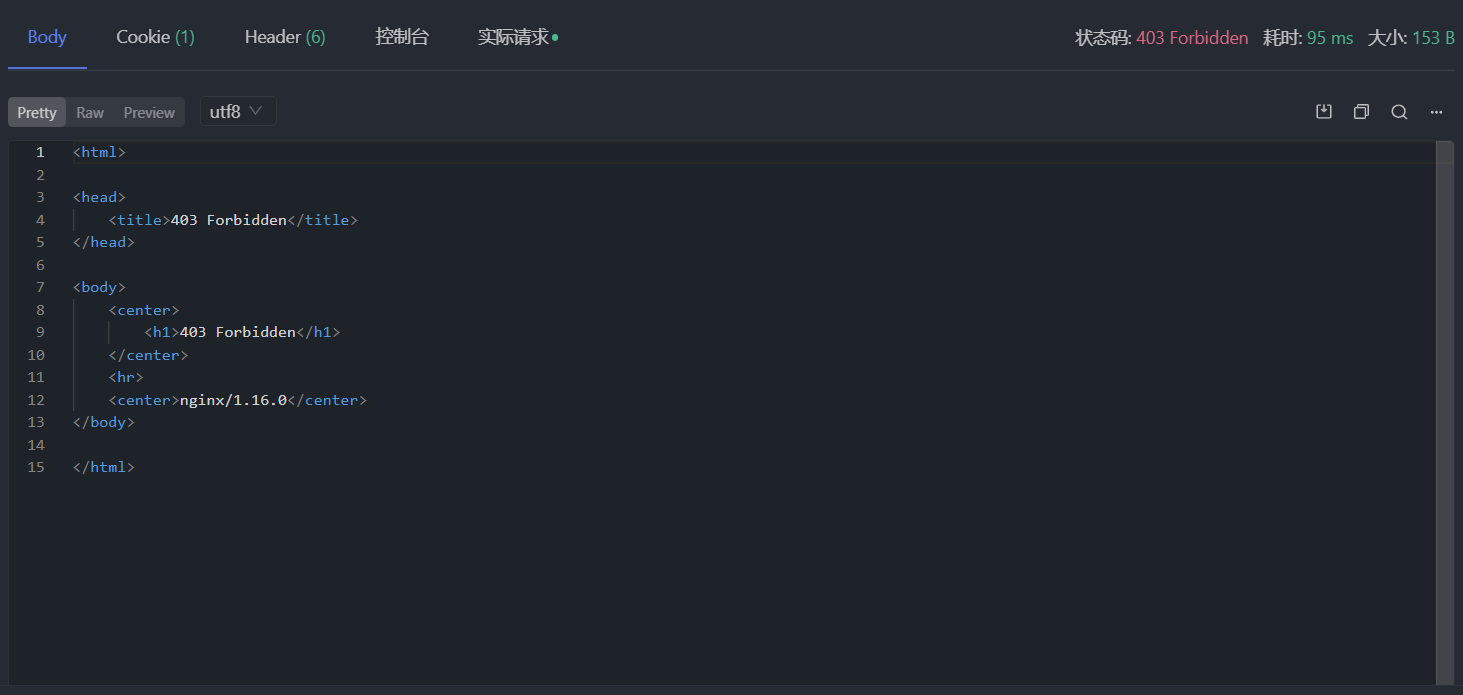
在没有设置额外请求头的情况下发个请求试试,发现 403 Forbidden 了,emmmmm,应该是防盗链所致:
可以看到浏览器发出的请求的请求头中有设置 Referer 字段,把它加上,应该不会再报错了吧:
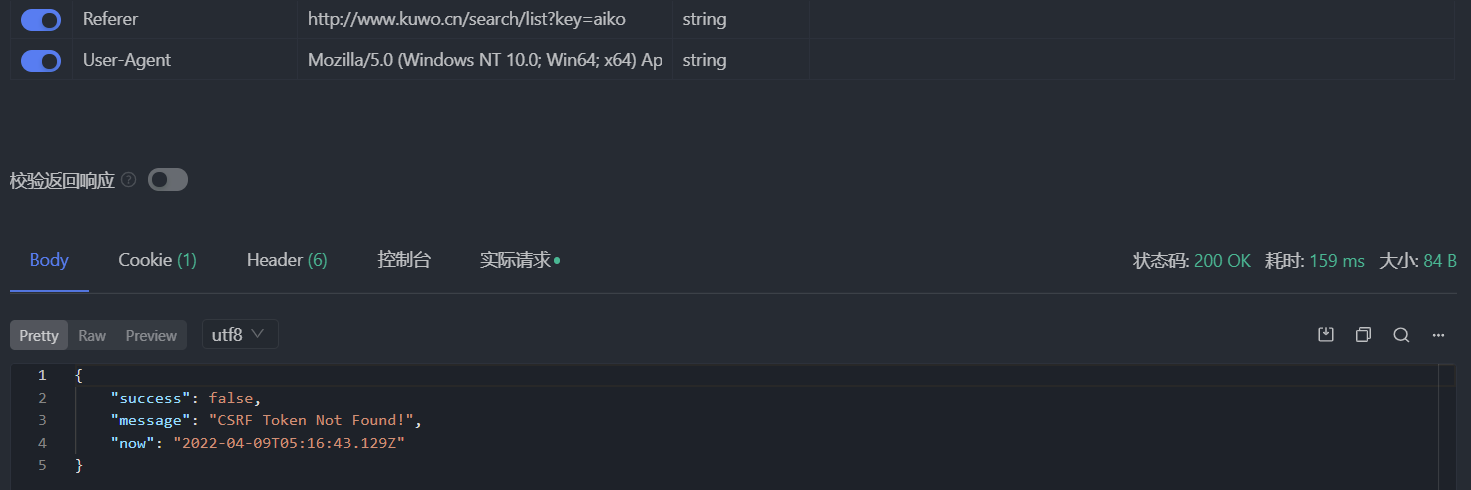
这次状态码为 200,但是没有收到任何数据,success 为 false 说明请求失败了,message 指明了失败原因是缺少 CSRF token。问题不大,接着把浏览器发出的请求中的 csrf 加到 Apifox 请求头中,再发请求,还是报错 CSRF token Invalid!。算了,还是老老实实把 Cookie 也加上吧,但也不是全部加上,只加 kw_token=CCISYM2HV96 部分,因为 Cookie 里面只有这个字段和 token 有关系且它的值和 csrf 相同。
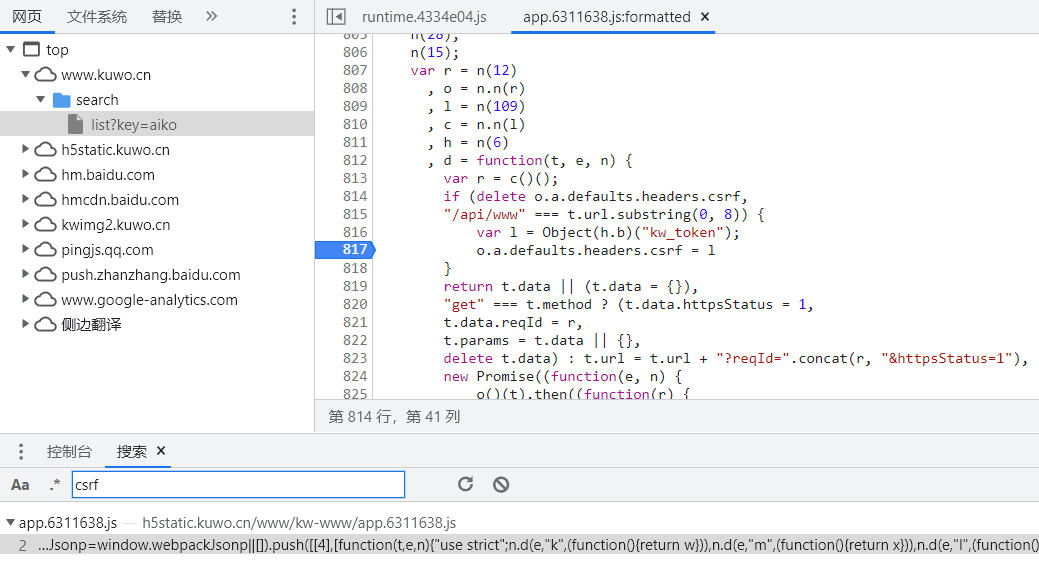
在源代码面板按下 ctrl + shift + f,搜索一下 csrf,可以看到 csrf 本来就是来自 Object(h.b)("kw_token"),这个函数用来取出 document.cookie 中的 kw_token 字段值。至于 Cookie 中的 kw_token 怎么计算得到的,那就是服务器的事情了,咱们只管 CV 操作即可。
准备好参数和请求头,重新发送请求,可以得到想要的数据。如果去掉 reqId 参数,也可以拿到数据,但是会有略微的不同,这里就不贴出来了:
{ "code": 200, "curTime": 1649482287185, "data": { "total": "741", "list": [ { "musicrid": "MUSIC_11690555", "barrage": "0", "ad_type": "", "artist": "aiko", "mvpayinfo": { "play": 0, "vid": 8530326, "down": 0 }, "nationid": "0", "pic": "http://img4.kuwo.cn/star/starheads/500/24/88/4146545084.jpg", "isstar": 0, "rid": 11690555, "duration": 362, "score100": "42", "ad_subtype": "0", "content_type": "0", "track": 1, "hasLossless": true, "hasmv": 1, "releaseDate": "1970-01-01", "album": "", "albumid": 0, "pay": "16515324", "artistid": 1907, "albumpic": "http://img4.kuwo.cn/star/starheads/500/24/88/4146545084.jpg", "originalsongtype": 0, "songTimeMinutes": "06:02", "isListenFee": false, "pic120": "http://img4.kuwo.cn/star/starheads/120/24/88/4146545084.jpg", "name": "恋をしたのは", "online": 1, "payInfo": { "play": "1100", "nplay": "00111", "overseas_nplay": "11111", "local_encrypt": "1", "limitfree": 0, "refrain_start": 89150, "feeType": { "song": "1", "vip": "1" }, "down": "1111", "ndown": "11111", "download": "1111", "cannotDownload": 0, "overseas_ndown": "11111", "refrain_end": 126247, "cannotOnlinePlay": 0 }, "tme_musician_adtype": "0" } ] }, "msg": "success", "profileId": "site", "reqId": "4b55cf4b0171253c33ce1d71b999c42f", "tId": ""}响应结果的 data 字段中有很多东西,这里只提取需要的部分。在提取之前先来定义一下歌曲信息实体类,这样在其他函数中要一首歌曲的信息时只要把实体类的实例传入即可。
# coding:utf-8from copy import deepcopyfrom dataclasses import dataclassclass Entity: """ Entity abstract class """ def __setitem__(self, key, value): self.__dict__[key] = value def __getitem__(self, key): return self.__dict__[key] def get(self, key, default=None): return self.__dict__.get(key, default) def copy(self): return deepcopy(self)@dataclassclass SongInfo(Entity): """ Song information """ file: str = None title: str = None singer: str = None album: str = None year: int = None genre: str = None duration: int = None track: int = None trackTotal: int = None disc: int = None discTotal: int = None createTime: int = None modifiedTime: int = None上述代码显示定义了实体类的基类,并且重写了 __getitem__ 和 __setitem__ 魔法方法,这样我们可以像访问字典一样来访问实体类对象的属性。接着让歌曲信息实体类继承了实体类基类,并且使用 @dataclass 装饰器,这是 python 3.7 引入的新特性,使用它装饰之后的实体类无需实现构造函数、__str__等常用函数,python 会帮我们自动生成。
在发送请求的过程中可能会遇到各种异常,如果在代码里面写 try except 语句会显得很乱,这里同样可以用装饰器来解决这个问题。
# coding:utf-8from copy import deepcopydef exceptionHandler(*default): """ decorator for exception handling Parameters ---------- *default: the default value returned when an exception occurs """ def outer(func): def inner(*args, **kwargs): try: return func(*args, **kwargs) except BaseException as e: print(e) value = deepcopy(default) if len(value) == 0: return None elif len(value) == 1: return value[0] else: return value return inner return outer下面是发送获取歌曲信息请求的代码,使用 exception_handler 装饰了 getSongInfos 方法,这样发生异常时会打印异常信息并返回默认值:
# coding:utf-8import jsonfrom urllib import parsefrom typing import List, Tupleimport requestsclass KuWoMusicCrawler: """ Crawler of KuWo Music """ def __init__(self): super().__init__() self.headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) ' 'AppleWebKit/537.36 (KHTML, like Gecko) Chrome/71.0.3578.98 Safari/537.36', 'Cookie': 'kw_token=C713RK6IJ8J', 'csrf': 'C713RK6IJ8J', 'Host': 'www.kuwo.cn', 'Referer': '' } @exceptionHandler([], 0) def getSongInfos(self, key_word: str, page_num=1, page_size=10) -> Tuple[List[SongInfo], int]: key_word = parse.quote(key_word) # configure request header headers = self.headers.copy() headers["Referer"] = 'http://www.kuwo.cn/search/list?key='+key_word # send request for song information url = f'http://www.kuwo.cn/api/www/search/searchMusicBykeyWord?key={key_word}&pn={page_num}&rn={page_size}&reqId=c06e0e50-fe7c-11eb-9998-47e7e13a7206' response = requests.get(url, headers=headers) response.raise_for_status() # parse the response data song_infos = [] data = json.loads(response.text)['data'] for info in data['list']: song_info = SongInfo() song_info['rid'] = info['rid'] song_info.title = info['name'] song_info.singer = info['artist'] song_info.album = info['album'] song_info.year = info['releaseDate'].split('-')[0] song_info.track = info['track'] song_info.trackTotal = info['track'] song_info.duration = info["duration"] song_info.genre = 'Pop' song_info['coverPath'] = info.get('albumpic', '') song_infos.append(song_info) return song_infos, int(data['total'])虽然我们实现了搜索歌曲的功能,但是没拿到每一首歌的播放地址,也就没办法把歌曲下载下来。我们先来播放一首不收费的歌曲试试。可以看到浏览器发送了一个获取播放链接的请求,路径为 http://www.kuwo.cn/api/v1/www/music/playUrl,有两个需要关注的参数:
mid:音乐 Id,此处的值为 941583,和页面 url 中的编号一致,由于我们是通过点击搜索结果页面中 二人 跳转过来的,而 二人 这条结果也是动态加载出来的,超链接中的 Id 肯定也来自于上一节中响应结果的某个字段。二人 是第四条记录,通过对比可以发现 data.list[3].rid 就是 mid;type:音乐类型?此处的值为 music,发送请求的时候也设置为 music 即可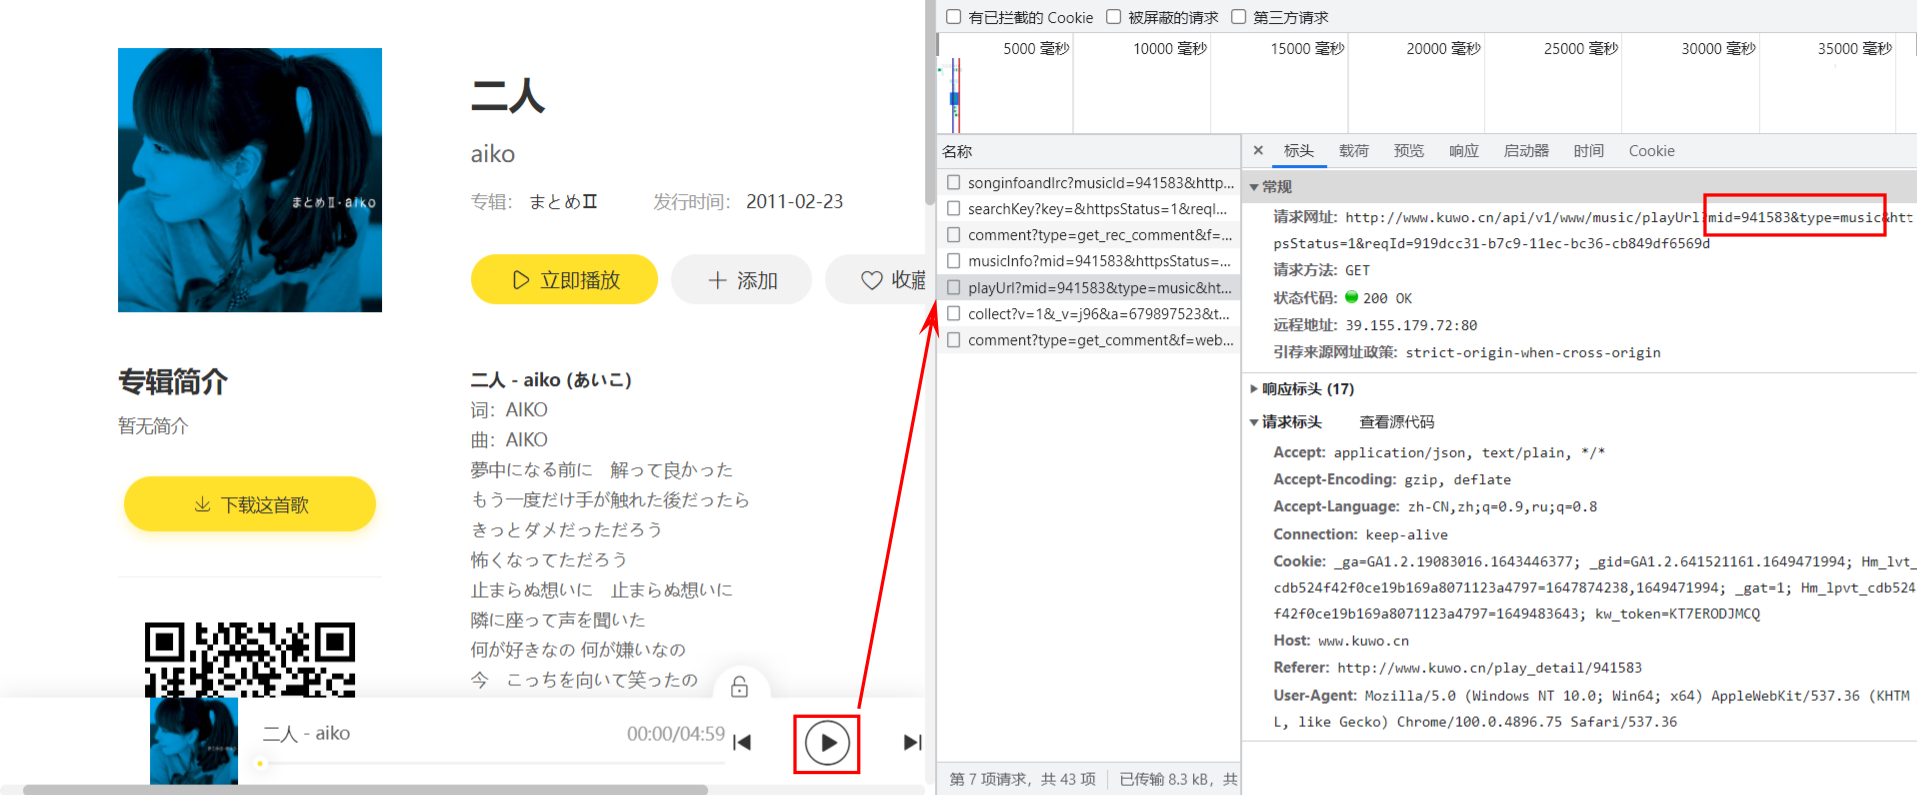
在 Apifox 中新建一个获取歌曲播放地址的请求,如下所示,发现可以成功拿到播放地址:

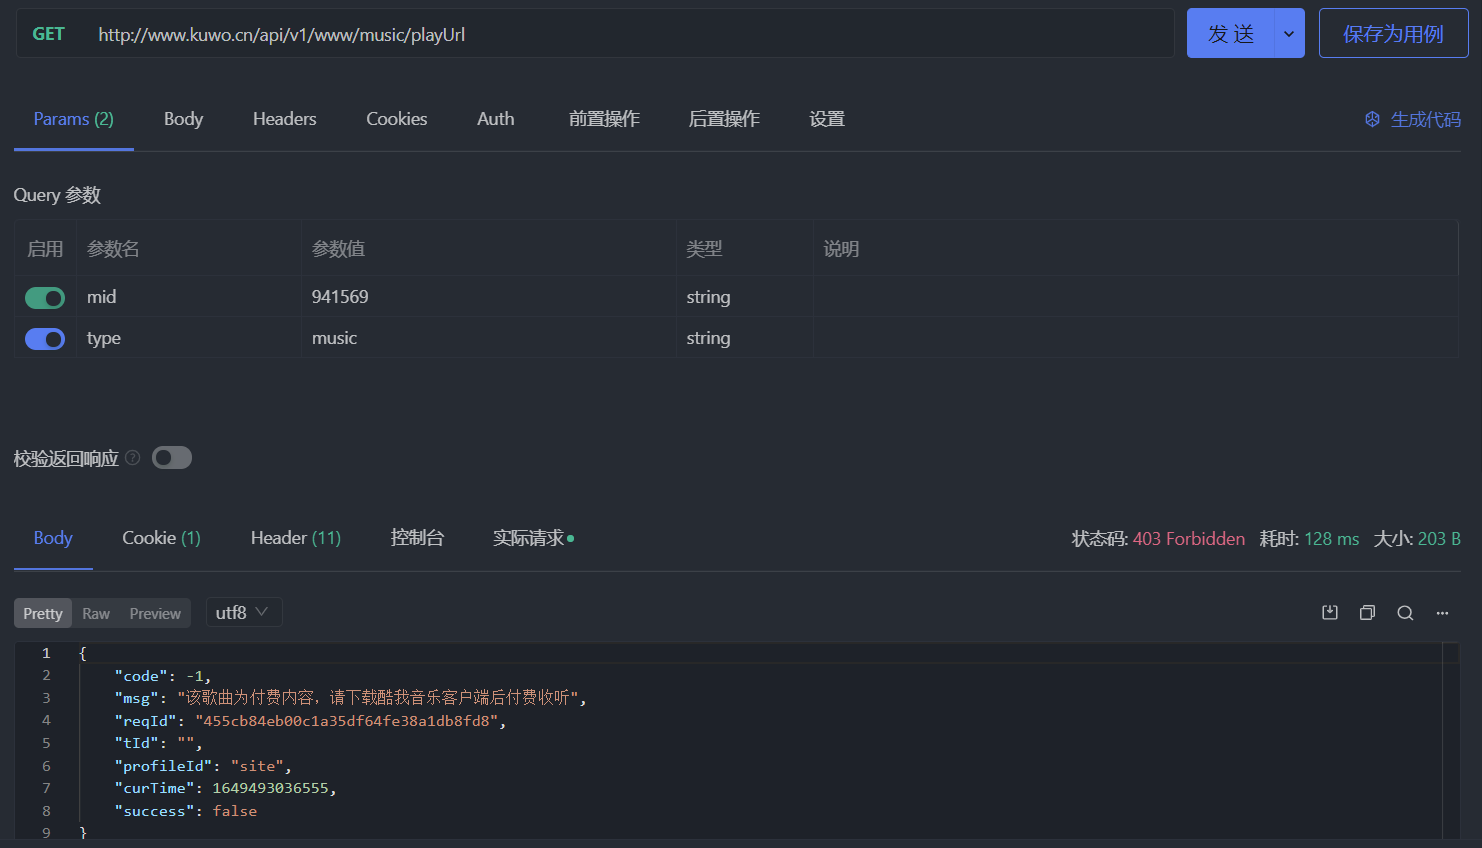
现在换一首歌,比如 aiko - 横颜,点击歌曲页面上的播放按钮时会弹出要求在客户端中付费收听的对话框。直接发送请求,响应结果会是下面这个样子,状态码为 403:
其实酷我在 2021 年 9 月份的时候换过获取播放地址的接口,那时候的请求接口为 http://www.kuwo.cn/url,支持以下几个参数:
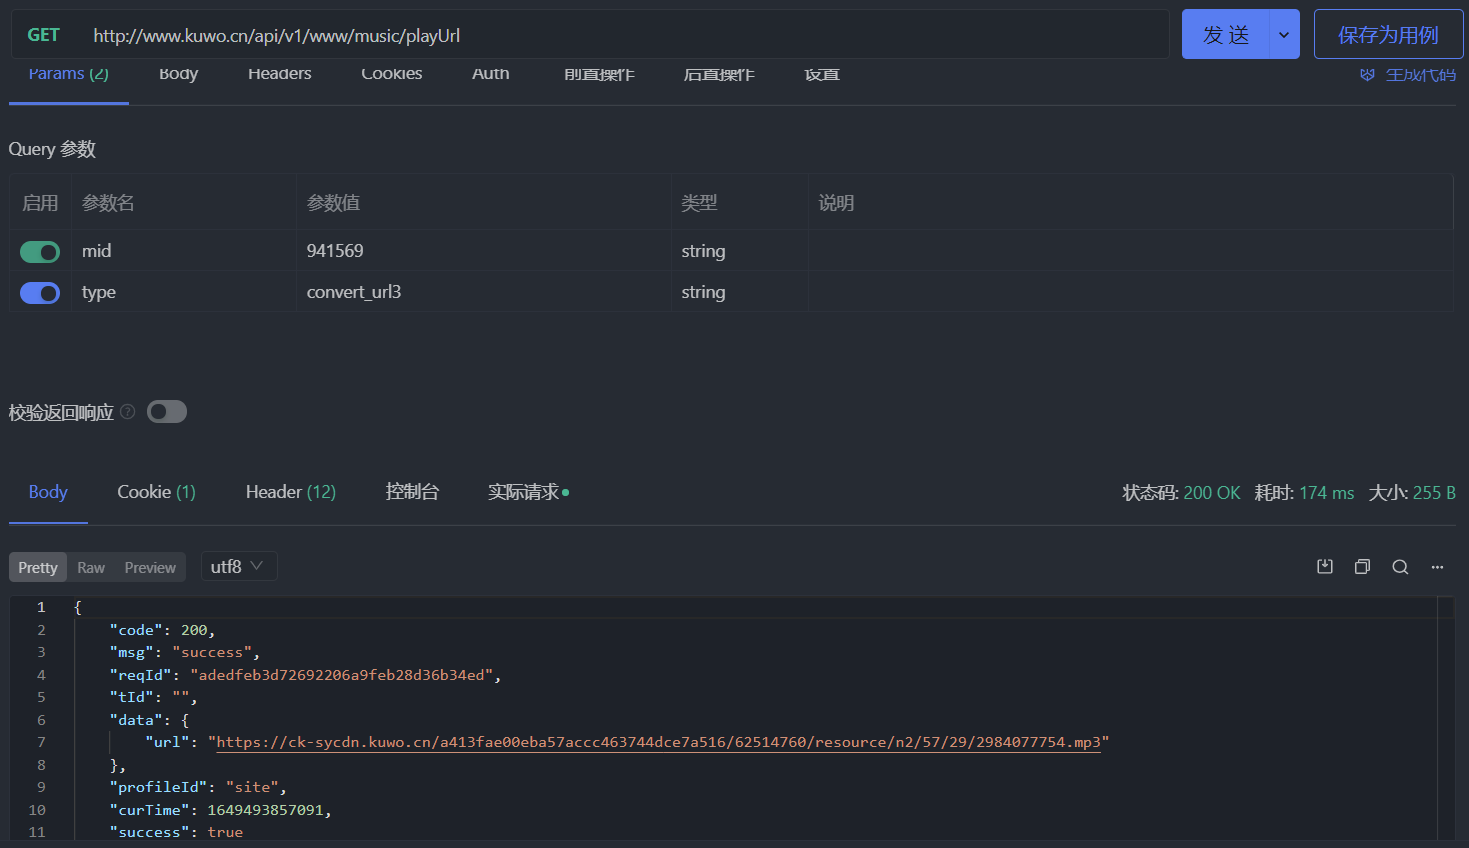
format: 在线音乐的格式,可以是 mp3type: 和现在的接口中的 type 参数一样,但是值为 convert_url3rid: 音乐 Id,和 mid 一样br: 在线音乐的比特率,越大则音质越高,可选的有 128kmp3、 192kmp3 和 320kmp3这个接口不管是付费音乐还是免费音乐都可以用。如果将现在这个接口的 type 参数的值换成 convert_url3,请求结果如下所示,说明成功了:
下面是获取在线音乐播放链接的代码,只需调用 downloadSong 函数并把爬取到的歌曲传入就能完成歌曲的下载:
@exceptionHandler('')def getSongUrl(self, song_info: SongInfo) -> str: # configure request header headers = self.headers.copy() headers.pop('Referer') headers.pop('csrf') # send request for play url url = f"http://www.kuwo.cn/api/v1/www/music/playUrl?mid={song_info['rid']}&type=convert_url3" response = requests.get(url, headers=headers) response.raise_for_status() play_url = json.loads(response.text)['data']['url'] return play_url@exceptionHandler('')def downloadSong(self, song_info: SongInfo, save_dir: str) -> str: # get play url url = self.getSongUrl(song_info) if not url: return '' # send request for binary data of audio headers = self.headers.copy() headers.pop('Referer') headers.pop('csrf') headers.pop('Host') response = requests.get(url, headers=headers) response.raise_for_status() # save audio file song_path = os.path.join( save_dir, f"{song_info.singer} - {song_info.title}.mp3") with open(song_path, 'wb') as f: f.write(data) return song除了获取歌曲的详细信息和播放地址外,我们还能拿到歌词、歌手信息等,方法是类似的,在我的 Groove 中提供了在线歌曲的功能,一部分接口就是来自酷我,还有一些来自酷狗和网易云,爬虫的代码在 app/common/crawler 目录下,喜欢的话可以给个 star 哦,以上~~